Содержание
- ⚡ Философия PowerShell (19)
- ✍️ Посты (1)
- Gemini CLI (3)
- LLM: статьи, практические материалы (14)
- 📑 Шпаргалки (16)
- 📖 Гайды (4)
- 📚 Учебные Материалы (13)
- 📝 Статьи (3)
- 🕰️ История IT (2)
- 📰 IT-Новости (3)
- 🛠️ DevOps (3)
- 🧪📓 Без категории (24)
- FrontEnd и Backend (2)
- Frontend (1)
- Базы данных (12)
- Системные промты дл медиатеки (3)
Коды линтеров Python: как их читать и понимать
1. Что такое код линтера Когда линтер анализирует Python-код, он может сообщить не просто: здесь проблема а, например: или: Буквенно-цифровая комбинация F401, E501 и т. п. называется кодом правила (rule code), кодом нарушения (violation code) или диагностическим кодом. Например: если os нигде не используется, может привести к: Код F401 позволяет однозначно понять, какое именно правило…
Читайте далееGoogle OAuth: где найти Client ID и Client Secret
Google OAuth часто выглядит запутанно, особенно когда авторизация уже настроена, а приложению внезапно требуется какой-то «ключ Google». На практике здесь обычно используются два связанных значения: В этой статье разберём, где их найти в Google Cloud Console и как отличить один от другого. 1. Что такое Google OAuth OAuth 2.0 — это механизм авторизации, который позволяет…
Читайте далееpersona.md
Почему именно такой документ Заметь, чего здесь нет. Нет: И это сделано специально. persona.md должен отвечать только на один вопрос: «Кто ты и как ты принимаешь решения?» Ни на что больше.
Читайте далее
1.10. Почему RAG иногда отвечает неправильно
На мой взгляд, Это самый важный раздел первой главы. Именно после него у читателя должна исчезнуть иллюзия, что RAG гарантирует правильные ответы. Большинство новичков думают: «Если добавить поиск по документам, галлюцинации исчезнут.» Это неверно. RAG значительно снижает вероятность ошибок, но не устраняет их полностью. Более того, он создает новые классы ошибок, которых вообще не существовало…
Читайте далее
RAG: от основ до Production
Большинство материалов по RAG страдают одной и той же проблемой: они объясняют как пользоваться библиотекой, но почти не объясняют почему именно так устроена система. В результате человек умеет написать десять строк на LangChain, но не понимает, почему поиск стал хуже после изменения размера чанка или почему другой embedding резко ухудшил качество ответов. Инженерия RAG Полное…
Читайте далее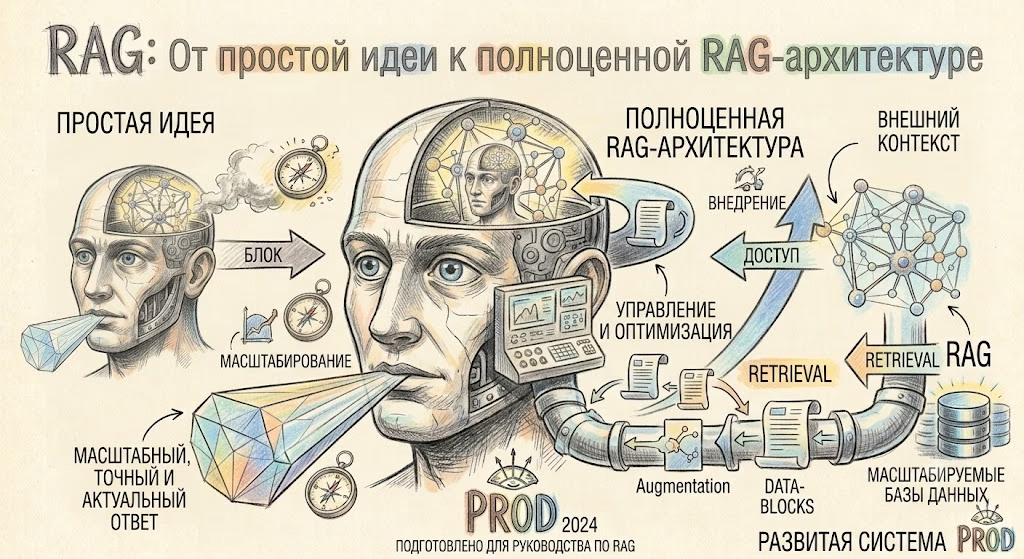
1.1 От идеи к полноценной RAG-архитектуре
Продолжаем. Теперь мы переходим к очень важному разделу первой главы. Здесь мы разрушим еще одну распространенную иллюзию: RAG — это не просто «добавить документы в prompt». Современный RAG — это полноценная информационная система, где качество ответа определяется не только LLM, а всей цепочкой обработки данных. На предыдущем этапе мы получили минимальную схему: Эта схема правильная.…
Читайте далее
Microsoft Foundry Local CLI: Полное руководство по управлению локальными ИИ-моделями
Интерфейс CLI разделен на три логические группы: service (управление фоновым процессом), model (работа с нейросетями) и cache (управление файлами). 1. Начало работы и общая справка Если вы только установили Foundry, первыми командами для проверки работоспособности будут: Для получения расширенной информации о конкретных разделах используйте: 2. Управление сервисом (Service) Сервис — это фоновый процесс, который отвечает…
Читайте далее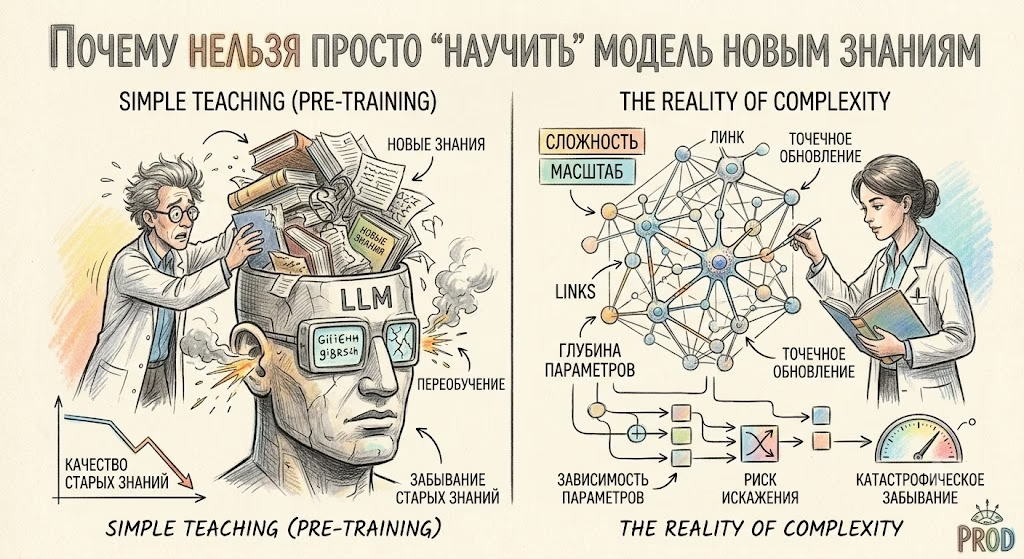
1.2. Почему нельзя просто «научить» модель новым знаниям
После знакомства с предыдущим разделом у многих возникает вполне естественный вопрос. Если проблема заключается в том, что модель не знает новых документов, почему бы просто не добавить эти документы в её память? На первый взгляд решение кажется очевидным. Появилась новая инструкция? => Переобучили модель. Изменился закон? => Добавили новый текст в обучение. Вышла новая версия…
Читайте далее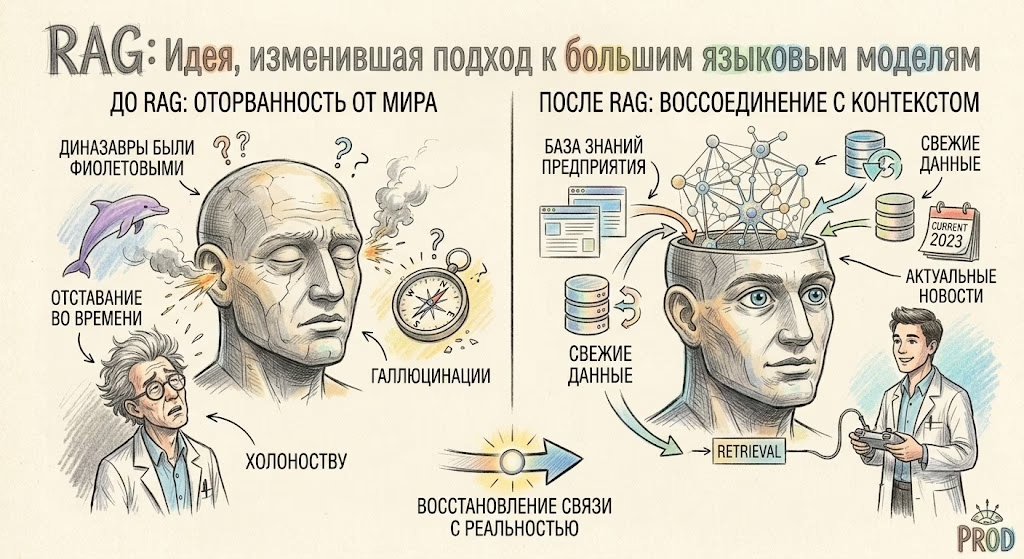
1.3. Идея, изменившая подход к большим языковым моделям
К этому моменту мы установили несколько важных фактов. Во-первых, большая языковая модель не является поисковой системой. Во-вторых, её знания зафиксированы на момент окончания обучения. В-третьих, регулярное переобучение модели практически невозможно из-за высокой стоимости, сложности и риска потери уже усвоенных знаний. Если посмотреть на эти ограничения вместе, возникает интересный вопрос. Почему мы вообще пытаемся заставить модель…
Читайте далее1.4. От простой идеи к полноценной RAG-архитектуре
На предыдущем этапе мы получили минимальную схему: Эта схема правильная. Но она слишком сильно упрощена. Она похожа на описание автомобиля: «Автомобиль состоит из двигателя, четырех колес и руля.» Формально это правда. nо если мы захотим построить настоящий автомобиль, нам придется разобраться в: С RAG происходит то же самое. Сама идея проста. Реализация сложна. Каждый блок…
Читайте далее
1.5. Query Processing — подготовка запроса
Первое, что делает пользователь, — формулирует вопрос. Например: Как настроить резервное копирование PostgreSQL? Для человека этот вопрос понятен, но для поисковой системы он может быть недостаточно оптимальным. Почему? Потому что пользователь формулирует вопрос с точки зрения своей задачи, а система поиска должна найти документы. Это не всегда одно и то же. Проблема естественного языка Рассмотрим…
Читайте далее1.6. Query Embedding
После подготовки запроса следующий этап — преобразование текста в числовое представление. Например: становится: Тысячи чисел. Этот набор чисел называется embedding vector Почему это необходимо Компьютер плохо понимает смысл текста напрямую. Для него: и это разные последовательности символов. Но человек понимает, что смысл близкий. Embedding-модель пытается сделать так, чтобы похожие по смыслу тексты находились рядом в…
Читайте далее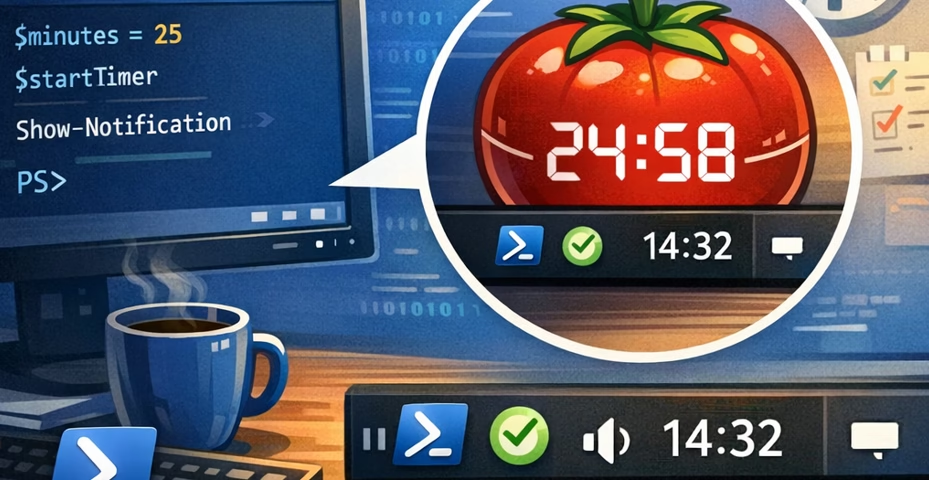
Создаем свой Pomodoro-таймер в системном трее на чистом PowerShell
Техника Pomodoro — это популярный метод управления временем, разработанный Франческо Чирилло в конце 1980-х. Его суть проста: вы разбиваете работу на 25-минутные интервалы (называемые «помидорами»), разделенные короткими 5-минутными перерывами. После каждых четырех циклов следует длинный перерыв. Это помогает сохранять концентрацию, избегать выгорания и лучше контролировать рабочий процесс. В этой статье я покажу, как написать свой…
Читайте далее
Руководство по WSL: Linux в Windows
Хотите использовать инструменты в Linux (Docker, Python, Node.js), не выходя из Windows? К вашим услугам WSL (Windows Subsystem for Linux). Это полноценное ядро Linux, работающее параллельно с вашей основной системой. Прежде чем начать, загляните в BIOS вашего компьютера. Там должна быть включена виртуализация (VT-x или AMD-V). Без этой «галочки» Linux не запустится. Разберемся, как настроить…
Читайте далее
ГЛАВА 13: Переключение на production и финализация
Руководство по миграции MySQL → MariaDB. ГЛАВА 13: Переключение на production и финализация. Цель главы: Безопасно переключиться на MariaDB и завершить миграцию
Читайте далее
ГЛАВА 11: Резервное копирование и восстановление
Руководство по миграции MySQL → MariaDB. ГЛАВА 11: Резервное копирование и восстановление. Цель главы: Настроить надежную систему резервного копирования
Читайте далее
ГЛАВА 9: Настройка безопасности
Руководство по миграции MySQL → MariaDB. ГЛАВА 9: Настройка безопасности. Цель главы: Защитить MariaDB от несанкционированного доступа
Читайте далее
ГЛАВА 8: Оптимизация производительности
Руководство по миграции MySQL → MariaDB. ГЛАВА 8: Оптимизация производительности. Цель главы: Настроить MariaDB для оптимальной производительности
Читайте далее
ГЛАВА 7: Проверка и тестирование миграции
Руководство по миграции MySQL → MariaDB. ГЛАВА 7: Проверка и тестирование миграции. Цель главы: Убедиться в успешности миграции
Читайте далееГЛАВА 6: Миграция пользователей и привилегий
Руководство по миграции MySQL → MariaDB. ГЛАВА 6: Миграция пользователей и привилегий. Цель главы: Восстановить пользователей и их привилегии
Читайте далее
ГЛАВА 5: Импорт данных из MySQL
Руководство по миграции MySQL → MariaDB. ГЛАВА 5: Импорт данных из MySQL. Цель главы: Восстановить данные из MySQL бэкапа в MariaDB
Читайте далее
ГЛАВА 4: Установка MariaDB Server
Цель главы: Установить и выполнить первичную настройку MariaDB
Читайте далее