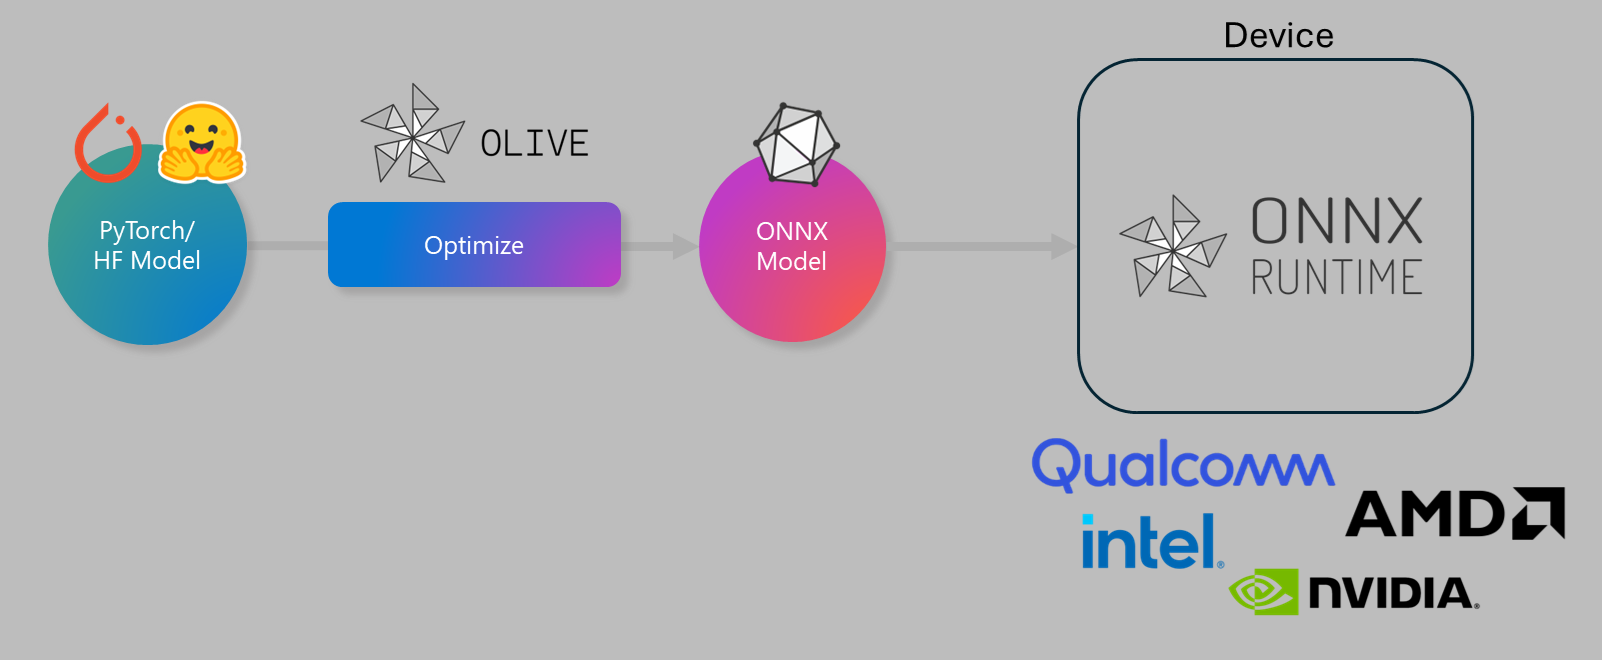
Microsoft Olive (акроним от ONNX Live) — это передовая платформа с открытым исходным кодом от Microsoft, созданная для комплексной оптимизации моделей искусственного интеллекта. Её главная цель — сделать процесс подготовки моделей машинного обучения для реального использования максимально простым, быстрым и эффективным, независимо от того, на каком оборудовании они будут работать — будь то центральные процессоры (CPU), мощные графические ускорители (GPU) или специализированные нейронные процессоры (NPU).
Проще говоря, Olive берет вашу исходную модель (например, из PyTorch или Hugging Face) и превращает её в высокопроизводительную версию в формате ONNX, которая идеально настроена для конкретного устройства.
Весь процесс можно представить как интеллектуальный конвейер: на вход подается модель, Olive анализирует её и целевое оборудование, применяет лучшую последовательность оптимизаций и на выходе выдает готовый к использованию, компактный и быстрый артефакт.
Как работает Olive: концепция «проходов» (Passes)
В основе работы Olive лежит идея структурированного рабочего процесса (workflow), который состоит из последовательности отдельных задач оптимизации, называемых «проходами» (passes). Каждый проход отвечает за конкретное улучшение модели.
Основные типы проходов включают:
- Конвертация (OnnxConversion): Преобразование модели из её исходного фреймворка (например, PyTorch) в универсальный формат ONNX.
- Оптимизация графа (Graph Optimization): Анализ и перестроение вычислительного графа модели для устранения избыточных операций и слияния нескольких шагов в один.
- Квантизация (Quantization): Снижение точности вычислений (например, с 32-битных до 8-битных чисел), что значительно уменьшает размер модели и ускоряет её работу, особенно на CPU и NPU.
- Сжатие и дообучение (Pruning & Finetuning): Удаление ненужных связей в нейронной сети и дополнительное «тонкое» обучение для сохранения точности после оптимизаций.
Olive может автоматически подбирать наилучшую комбинацию этих проходов и их параметров, чтобы найти идеальный баланс между точностью модели и скоростью её работы.
Ключевые преимущества использования Olive
- Сокращение ручного труда: Автоматизирует подбор сложных техник оптимизации, экономя время и усилия.
- Высокая производительность: Создает модели, которые максимально эффективно используют ресурсы целевого оборудования от Intel, AMD, Nvidia, Qualcomm и других.
- Простой интерфейс: Удобная командная строка (CLI) позволяет выполнять стандартные задачи оптимизации одной командой.
- Гибкость и контроль: Для сложных сценариев поддерживается детальная настройка через конфигурационные файлы YAML/JSON.
- Интеграция с экосистемой: Бесшовно работает с ONNX Runtime, высокопроизводительным движком для запуска моделей.
- Поддержка современных архитектур: Включает готовые рецепты для оптимизации новейших моделей, включая большие языковые модели (LLM).
Практическое руководство: Установка и использование
1. Установка
Настоятельно рекомендуется устанавливать Olive в виртуальное окружение Python, чтобы избежать конфликтов зависимостей.
# Создайте и активируйте виртуальное окружение
python -m venv olive-env
source olive-env/bin/activate  # Для Windows: olive-env\Scripts\activate

# Установите базовый пакет Olive и зависимости для PyTorch
pip install microsoft-olive[pytorch]

# Для работы с моделями из Hugging Face также понадобится библиотека transformers
pip install transformers

# Для автоматической оптимизации LLM, как в примере ниже
pip install microsoft-olive[auto-opt] transformers onnxruntime-genai
2. Быстрый старт: Оптимизация LLM через командную строку
В этом примере мы возьмем современную языковую модель Qwen/Qwen2.5-0.5B-Instruct из репозитория Hugging Face и применим к ней 4-битную квантизацию.
olive optimize \
    --model_name_or_path Qwen/Qwen2.5-0.5B-Instruct \
    --precision int4 \
    --output_path models/qwen
Совет для пользователей PowerShell: Символы переноса строк отличаются. Используйте следующую команду:
olive optimize `
    --model_name_or_path Qwen/Qwen2.5-0.5B-Instruct `
    --precision int4 `
    --output_path models/qwen
Что здесь происходит?
--model_name_or_path: Olive автоматически скачает указанную модель из Hugging Face.--precision int4: Это указание на применение 4-битной квантизации.--output_path: Директория для сохранения оптимизированной модели.
После выполнения Olive загрузит модель, преобразует её в ONNX, применит квантизацию и сохранит результат.
3. Продвинутый метод: Оптимизация через JSON-конфигурацию
Для сложных задач, требующих большего контроля, лучшим подходом является использование конфигурационного файла. Это делает процесс более наглядным и воспроизводимым.
Шаг 1: Создайте файл config.json
Давайте оптимизируем модель distilbert для классификации текста, применив конвертацию в ONNX и динамическую квантизацию.
{
    "input_model": {
        "type": "PyTorchModel",
        "config": {
            "model_name": "distilbert-base-uncased-finetuned-sst-2-english",
            "task": "text-classification",
            "io_config": {
                "input_names": ["input_ids", "attention_mask"],
                "output_names": ["logits"],
                "dynamic_axes": {
                    "input_ids": { "0": "batch_size", "1": "sequence_length" },
                    "attention_mask": { "0": "batch_size", "1": "sequence_length" },
                    "logits": { "0": "batch_size" }
                }
            }
        }
    },
    "passes": {
        "conversion": {
            "type": "OnnxConversion"
        },
        "quantization": {
            "type": "OnnxQuantization",
            "config": {
                "quant_mode": "dynamic"
            }
        }
    },
    "engine": {
        "output_dir": "optimized_distilbert"
    }
}
Шаг 2: Запустите оптимизацию с этим файлом
Команда в терминале становится предельно простой:
olive optimize --config config.jsonЭтот метод дает вам полный контроль над каждым шагом: вы можете точно указать параметры для каждого «прохода», определить входы и выходы модели (io_config) и легко управлять всем процессом.
Что дальше: Запуск модели с ONNX Runtime
ONNX Runtime (ORT) — это быстрый и кроссплатформенный движок для инференса (выполнения) моделей, оптимизированных с помощью Olive. Он позволяет встраивать ИИ-модели в ваши приложения на Python, C++, C#, Java и других языках, выполняя инференс прямо на устройстве.
Пример чат-приложения для LLM-моделей, оптимизированных Olive, доступен в файле model-chat.py в репозитории onnxruntime-genai на GitHub.